种鸡智能监测
01课题概况
养殖场环境下,鸡只存在高密度堆叠、互相遮挡、姿态多变、光照差异大等困难, 常规监控手段难以做到个体级别的连续观测。本课题围绕两条数据主线,构建可落地的检测与监测方案。
要解决什么问题
规模化鸡舍的日常管理目前大量依赖人工:数鸡、看精神状态、找病鸡、观察采食。 在几千到几万只的鸡舍里,这些工作靠人几乎不可能做到连续、个体级别的观测:
- 只能抽样,做不到普查 —— 一名饲养员要管上万只鸡,巡视一圈只能看个大概, 鸡舍深处的个体根本照看不到
- 人工进场会惊扰鸡群 —— 人一走进去,鸡只聚集、踩踏、短时停止采食, 观测行为本身就改变了被观测对象
- 夜间与短时异常抓不到 —— 异常往往发生在无人时段, 而人工巡检一天只有几次,时间窗口太粗
- 判断标准因人而异 —— 「精神好不好」靠经验,换个人结论就不同, 无法沉淀成可量化、可复现的指标
本课题的目标是用摄像头 + 检测算法替代「人的眼睛」,让系统自动回答三个问题:
| 要回答的问题 | 对应到算法上是什么 |
|---|---|
| 鸡舍里有多少只鸡? | 逐图计数 —— 数出该图检测框的个数 |
| 每只鸡在什么位置? | 个体定位 —— 为每个个体输出边界框 (x1, y1, x2, y2) |
| 哪一只有异常? | 框内再分析 —— 在检测框范围内做温度反演、姿态判断、运动统计 |
为什么用目标检测模型,而不是别的办法
「感知鸡群」有很多条技术路径,但它们能回答的问题层次完全不同 —— 这也是本课题最终选择目标检测的原因:
| 方案 | 能回答什么 | 为什么不够用 |
|---|---|---|
| 人工巡检 | 全部问题,但只是抽样 | 效率低、有应激、不连续、主观性强 |
| 称重台 / 环境传感器 | 群体平均体重、温湿度等环境量 | 需接触或称重设备;只能给出群体均值,无法定位到个体 |
| 红外对射 / 光电计数 | 粗略的「过了多少只」 | 鸡只拥挤同时通过时失效;无法区分个体,更无法给出位置 |
| 传统图像处理 背景差分、阈值分割、形态学 |
稀疏场景下的数量估计 | 对光照与地面反光极敏感;鸡只紧挨粘连时分不开; 参数需逐场景手调,换个鸡舍就失效 |
| 图像分类 CNN | 「这张图里有没有鸡」 | 只能回答整张图的类别,回答不了「在哪、有几只」 |
| 目标检测 | 有没有 + 在哪 + 是什么,且逐个个体输出 | 需要标注数据与算力 —— 这正是本课题要补上的部分 |
这层递进关系可以一句话说清: 分类只管「整张图里大概有什么」,只有检测才会为每一个个体单独给出一个框。 而计数、定位、个体跟踪,以及在框内做温度反演、姿态判断 —— 全都依赖「一个个体一个框」这个输出。 所以检测是整个技术链路的前置环节,也是本课题的核心; 它内部具体怎么算,见 第 05 节。
为什么以 YOLO 系列为主线,还要横向对比这么多模型
- 速度与精度平衡好:单阶段、端到端,一次前向就出结果, 符合养殖场「实时连续监测」的需求 —— 不像两阶段方法要先产生候选区域再逐个分类
- 统一接口才能公平对比:Ultralytics 把 v5 / v8 / v9 / v10 等不同代际 收敛到同一套 API 与同一条训练流程上,使「换模型」变成改一行的操作。 这是能做出 25 组可比实验的前提 —— 否则不同代码库的训练细节差异会淹没模型本身的差异
- 规格齐全,覆盖两种部署路线:n / s 等小规格面向 Edge AI 边缘设备, 更大规格面向标准算力服务器,同一算法家族内可按算力预算选型
- 但选型不能照搬论文结论:文献里报出的高精度大多来自常规尺度的目标, 而本课题的目标又小又密。在这种极端场景下哪个模型更稳、哪类改进更有效, 必须实测才知道 —— 这正是 第 06 节基准表存在的意义
可见光 + 热红外
可直接用于检测训练
人工标注
单图最高 1,151 只
完整训练与评测
主线一 · 笼养蛋鸡健康监测
- 可见光与热红外成对采集、坐标校正对齐
- 鸡头检测 → 结合 TIR 反演鸡头温度
- 支撑行为识别、个体识别、计数与健康评估
- 数据来源:BClayinghens(Sensors 2024)
主线二 · 规模化肉鸡检测
- 商业鸡舍与试验原型鸡舍双场景对照
- 覆盖第 1–6 周完整生长周期
- 面向 Edge AI 轻量模型与标准算力两种路线
- 数据来源:PIO(Scientific Data 2026)
已开展的工作
- 梳理并整理两套公开数据集的目录规范、标注格式与元数据说明
- 搭建统一的 Ultralytics 训练工程,标准化数据集接入方式
- 完成 25 组检测模型的完整训练(200 轮)与验证,覆盖 YOLOv5 / v8 / v9 / v10 全系列与 RT-DETR 三种主干
- 汇总各模型的 P / R / mAP@50 / mAP@50-95,形成可对比的基准表
- 沉淀调参经验与数据增强策略,供后续多模态与轻量化研究复用
02数据集
两套数据集分别对应笼养蛋鸡的精细化多模态观测与规模化肉鸡的复杂场景检测, 在采集设备、场景尺度、标注规模上互为补充。
| 对比项 | BClayinghens | PIO |
|---|---|---|
| 对象 | 笼养蛋鸡 | 地面平养肉鸡 |
| 模态 | 可见光(RGB)+ 热红外(TIR) | 可见光(RGB) |
| 图像数量 | 61,133 | 1,487 |
| 标注量 | 63,693 个鸡头 | 327,288 个实例 |
| 采集时段 | 2022.04 – 2024.07 | 2023 年,连续 6 周 |
| 场景 | 5 个蛋鸡舍,约 960 笼位/轮 | 1 个商业鸡舍 + 1 个原型鸡舍 |
| 标注格式 | 鸡头目标框(配合 TIR) | YOLO 格式边界框 |
BClayinghens · 笼养蛋鸡 RGB-TIR 数据集
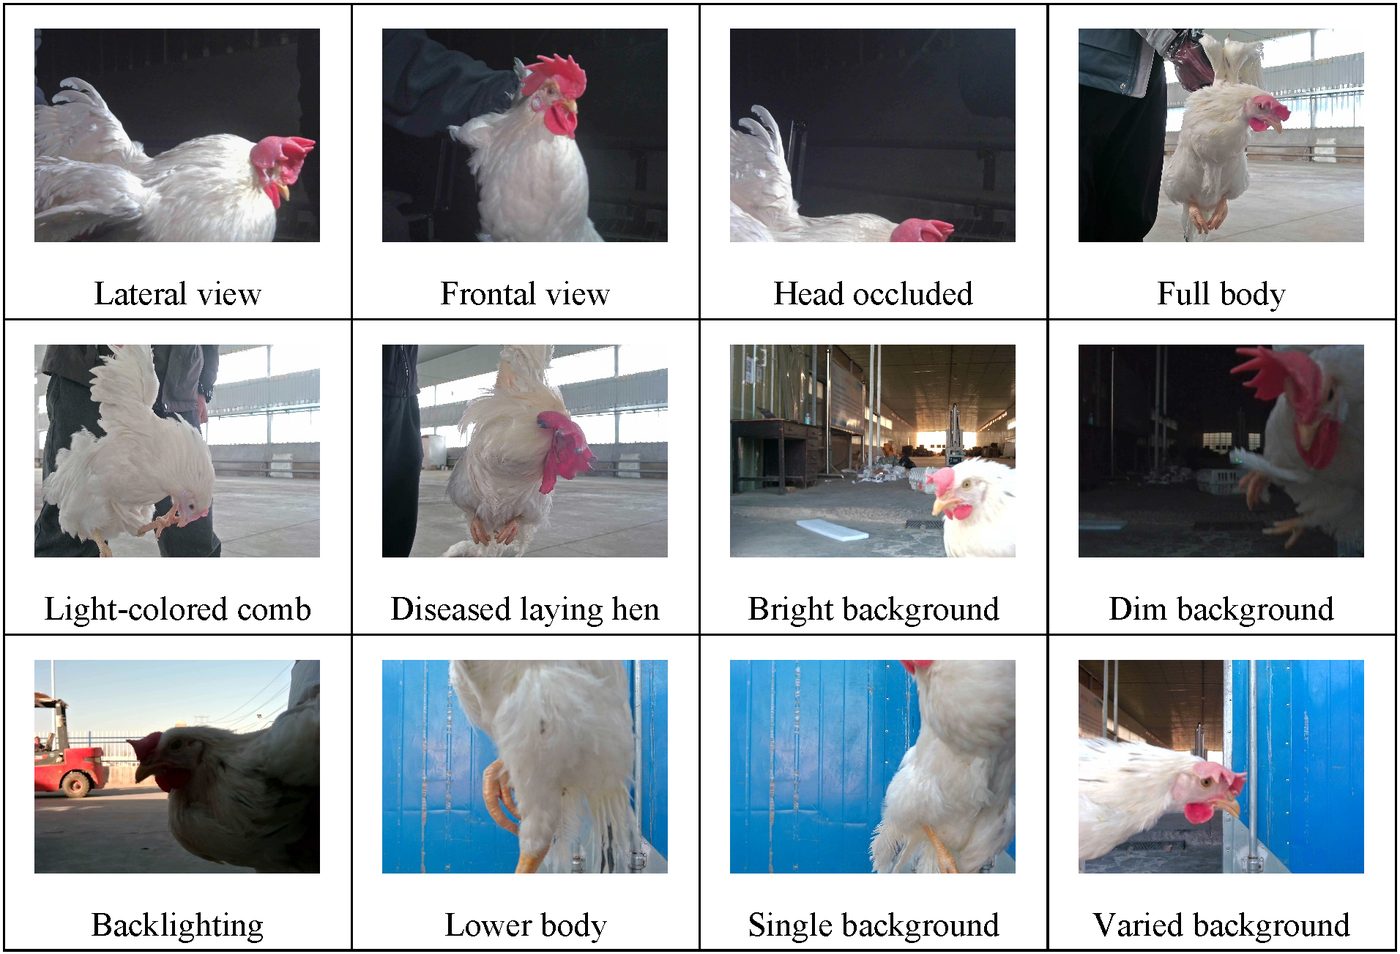
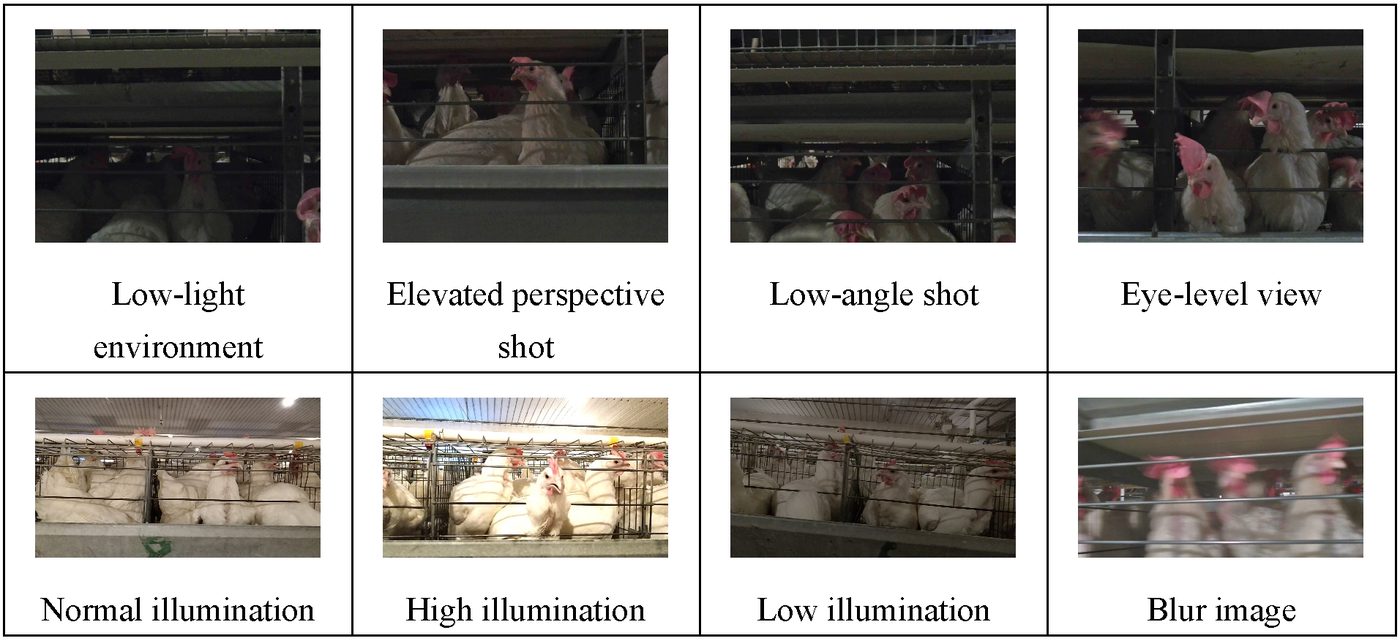
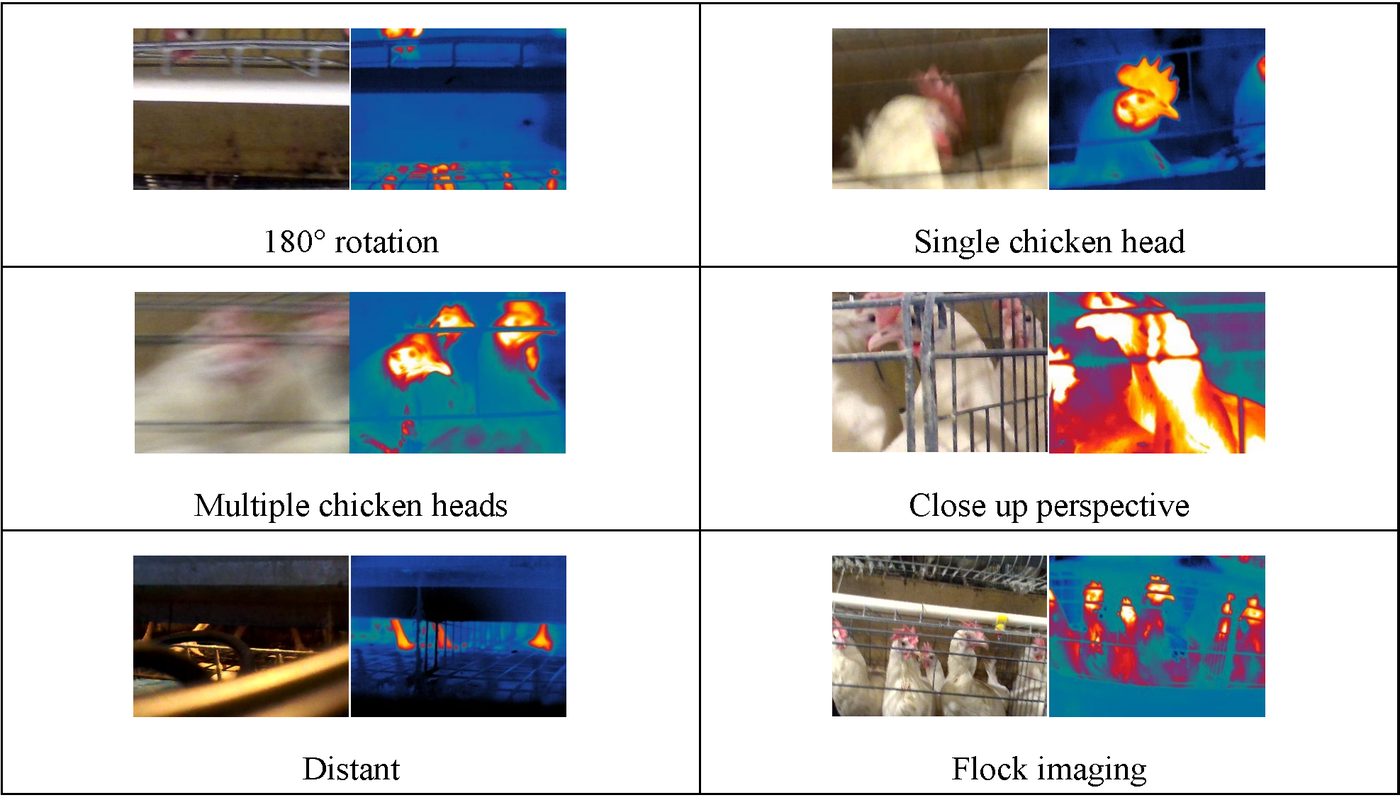
Sensors 2024, 24(19), 6385数据集包含 61,133 张蛋鸡可见光与热红外图像,每张 TIR 图像都配有一张对应的 RGB 图像, 并通过坐标校正实现位置对齐。可见光图像标注了 63,693 个鸡头标签, 可直接用于鸡头目标检测模型训练;结合配对的 TIR 数据即可分析鸡头温度信息。 面向任务包括鸡头目标检测、目标跟踪、姿态估计、行为识别、个体识别、鸡头温度检测与健康评估。
采集条件
- 时间跨度:2022 年 4 月 – 2024 年 7 月,5 个鸡舍分时段共 60 次采集,原始图像 30,993 张
- 鸡舍结构:10 列 × 8 层笼架,每 4 层设隔断;每笼 6–8 只蛋鸡,日龄 200–300 天
- 巡检方式:巡检机器人沿磁导航轨道运行,速度 3–30 m/min 十档可调, 单轮扫描约 960 个笼位,数据回传云端;升降机构行程 514–2519 mm
- 采集设备:HONOR ANN-AN00 手机(2592×1944);机器人载可见光相机 LRCP20680_1080P(1920×1080); 机器人载红外热像仪 FLIR A300(9 Hz,320×240)
- 配准方式:RGB 与 TIR 相机由采集系统集中控制,两次拍摄间隔约 1 秒,后期做坐标校正对齐
数据增强策略
为模拟不同鸡舍的光照差异、笼层高度差异与相机成像差异,数据集构建阶段采用了多种增强: R 通道随机增强(ΔR ∈ [10, 100])、色相与亮度调整、高斯噪声(σ = 51)、 拉普拉斯噪声与泊松噪声,以提升模型鲁棒性。
PIO · 规模化肉鸡检测数据集
Scientific Data (2026) 13:801PIO(Poultry Image Observations)包含 1,487 张人工标注图像(1,920 × 1,088)、 共计 327,288 个肉鸡实例,覆盖商业鸡舍与实验原型鸡舍两种对比环境, 跨越肉鸡第 1–6 周的完整生长周期。所有图像均以 YOLO 格式完成精确边界框标注。
密度:平均每图 220 个目标;训练集单图最高 1,151 个 (第 1 周雏鸡场景,如
C-W1-0061),验证集单图最高 594 个。
通用检测数据集通常是每图几个目标,本数据集是其几十倍 ——
这两组数字直接决定了显存占用、batch 上限与 max_det 的取值。
两个采集场景
| 参数 | 原型鸡舍 | 商业鸡舍 |
|---|---|---|
| 相机数量 | 4 | 36 |
| 每帧约含肉鸡 | 100 只 | 700 只 |
| 场地尺寸 | 6 m × 4 m(24 m²) | 12 m × 8 m |
| 录制安排 | 24 小时连续 | 24 小时连续 |
| 光照类型 | 混合(自然光 / 人工 LED) | 以自然光为主,夜间人工补光 |
采集与标注流程
- 设备:Hikvision DS-2CD1027G0-L 网络摄像机,原生分辨率 1920×1080
- 录制:2023 年对两类鸡舍全年全天候连续录制 6 周,覆盖从雏鸡入栏到出栏的全周期
- 抽帧:Python + OpenCV 配合多进程,每段视频抽取 250 帧
- 标注:2025 年完成人工标注;配套 Excel 文件记录命名规则, 可按周次、环境(commercial / prototype)与图像序号定位每张图
- 附带视频:随数据集提供鸡舍内录制视频,可用于二次抽帧扩充数据
生长阶段参考
- 初期(第 1 周):平均体重约 150 g,鸡只体型小、交叉与快速移动频繁
- 随周次增长,体型增大、密度上升,对检测模型的尺度适应能力要求提高
03工具链
实验基于 Ultralytics 统一框架,用同一套数据接入方式横向对比多种检测架构, 保证结果可比。
| 环节 | 工具 / 配置 | 说明 |
|---|---|---|
| 训练框架 | Ultralytics(YOLO 系列 + RT-DETR) | 统一 train / val / predict 接口 |
| 工程路径 | /root/data1/work/ultralytics-main | 模型定义位于 ultralytics/cfg/models/ |
| 数据集配置 | dataset/data.yaml | 声明 train / val 路径与类别 |
| 标注格式 | YOLO txt(归一化中心点 + 宽高) | 标注规范见《Data Annotation Guide》 |
| 计算设备 | 单卡训练,device=0 | batch 48 @ imgsz 640,AMP 混合精度 |
| 导出格式 | TorchScript(format: torchscript) | 便于后续部署到边缘设备 |
| 可视化 | Ultralytics 内置绘图 | 训练曲线、PR / F1 曲线、混淆矩阵、验证批次图 |
横向对比的模型清单
YOLO 系列(单阶段)
- YOLOv5:n / s / m / l / x
- YOLOv8:n / s / m / l / x
- YOLOv9:t / s / m / c / e
- YOLOv10:n / s / m / b / l / x
- 合计 21 个规格
RT-DETR 系列(端到端)
- RT-DETR-L
- RT-DETR-X
- RT-DETR-ResNet50
- RT-DETR-ResNet101
- 合计 4 个规格
04方法与配置
两类架构代表了当前目标检测的两条主流技术路线,本课题在同一数据与同一超参下进行对照实验。
技术路线对比
| 维度 | YOLO 系列 | RT-DETR 系列 |
|---|---|---|
| 检测范式 | 单阶段密集预测 | DETR 式端到端集合预测 |
| 后处理 | 需 NMS | 无需 NMS |
| 标签分配 | TAL 等动态分配 | 匈牙利匹配 |
| 优势 | 速度快、小模型性价比高、易于边缘部署 | 结构简洁、无 NMS 调参、大模型上限高 |
| 在本课题的表现 | mAP@50 普遍 0.97+,小模型亦能追平大模型 | mAP@50 约 0.96–0.97,略低于 YOLO 组 |
统一训练超参
以下配置取自训练产出的 args.yaml,所有模型保持一致,以确保对比公平。
| 参数 | 取值 | 参数 | 取值 |
|---|---|---|---|
| epochs | 200 | imgsz | 640 |
| batch | 48 | optimizer | SGD |
| lr0 | 0.01 | lrf | 0.01 |
| momentum | 0.937 | weight_decay | 0.0005 |
| warmup_epochs | 3.0 | patience | 50 |
| close_mosaic | 10 | amp | true |
| pretrained | true | seed / deterministic | 0 / true |
| cos_lr | false | workers | 8 |
数据增强设置
增强以几何变换与色彩扰动为主,不引入 mixup / copy-paste,避免在高密度遮挡场景下产生不真实样本。
| 增强项 | 取值 | 增强项 | 取值 |
|---|---|---|---|
| mosaic | 1.0 | close_mosaic | 10 |
| fliplr | 0.5 | flipud | 0.0 |
| hsv_h / hsv_s / hsv_v | 0.015 / 0.7 / 0.4 | degrees / shear / perspective | 0 / 0 / 0 |
| translate | 0.1 | scale | 0.5 |
| auto_augment | randaugment | erasing | 0.4 |
| mixup | 0.0 | copy_paste | 0.0 |
single_cls 为 false,
但数据本身仅一个类),因此 mAP 直接反映定位与召回质量。鸡头温度反演则是在检测框基础上,
叠加 TIR 像素值统计实现。
05检测算法是怎么算出来的
上一节讲了「用什么架构、配什么参数」,这一节回答一个更底层的问题:
把一张 640×640 的鸡舍图片丢进去,程序凭什么能吐出「这里有一只鸡,框在 (x1,y1,x2,y2)」?
下面每一步都对着本课题实际在用的 yolo26n 说明 ——
文中的结构参数是把你自己训练出的 best.pt 打开实测出来的,
不是抄的通用教程,所以能和你 results.csv 里的数字一一对上。
| 项目 | 实测值 | 意味着什么 |
|---|---|---|
| 参数量 | 2.57 M | 只占显存很小一块,是本课题选 n 版的原因 |
下采样步长 stride | 8 / 16 / 32 | 三个尺度同时预测,兼顾大小目标 |
| 候选点数 | 8400 | 80²+40²+20²,每个点都会给出一个「预测框」 |
reg_max | 1 | DFL 回归已被移除,直接回归距离 |
输出通道 no | 5 | = 4 个框坐标 + 1 个类别分,没有独立的「有没有物体」通道 |
| 损失项 | box / cls / l1 | 第三项是 l1_loss 而不是 dfl_loss,就是 reg_max=1 的直接结果 |
| 检测头分支 | one2many + one2one | 两套头同时训练,这是 YOLO26 免 NMS 的基础 |
从图片到特征图:逐级下采样
卷积网络没法直接「看」640×640 的原图,它要先把图逐级缩小、同时把通道加厚, 把像素变成一个更能表达语义的「特征图」。你的模型经过四次下采样,得到三个尺度的特征图:
输入图片        640 × 640 × 3
      ↓  Backbone 逐级下采样(stride 2 → 4 → 8 → 16 → 32)
P3 特征图        80 × 80          ← stride 8,格子最小,负责小目标
P4 特征图        40 × 40          ← stride 16,中等目标
P5 特征图        20 × 20          ← stride 32,格子最大,负责大目标
      ↓  Neck(FPN + PAN)把三个尺度互相融合
         自顶向下:把小尺度的语义信息传下来
         自底向上:把大尺度的位置信息传上去
      ↓  Detect 检测头
输出张量         1 × 5 × 8400
stride(步长)的意思是一个格子对应原图上多少像素。
stride 8 就是「特征图上一个点,代表原图 8×8 的一块区域」。
所以代码里做检测时,格子的坐标要乘回 stride 才能还原成原图像素坐标 ——
这一条在后面讲解码时会再用到。
8400 个候选点是怎么数出来的
输出张量里那个 8400 不是随便设的,它就是三个尺度上格子数的总和:
| 尺度 | 特征图尺寸 | 步长 | 候选点数 | 适合的目标 |
|---|---|---|---|---|
| P3 | 80 × 80 | 8 | 6400 | 小目标(本课题的鸡只属于这一档) |
| P4 | 40 × 40 | 16 | 1600 | 中等目标 |
| P5 | 20 × 20 | 32 | 400 | 大目标 |
| 合计 | 8400 | 每个点都会输出一整组预测 | ||
换句话说,模型对每张图会一口气给出 8400 个「我认为这里有东西」的候选框。 一张图里只有 200 多只鸡,所以 8400 个候选里绝大多数是错的, 整个训练过程本质上就是在教模型「哪些点该响应、哪些点该闭嘴」。
输出张量里每一位是什么
把那串 1 × 5 × 8400 拆开看,三个数字的含义完全不同:
| 维度 | 值 | 含义 |
|---|---|---|
| 第 1 维 | 1 | 批大小 —— 一次喂几张图。训练时是 16(你的 BATCH) |
| 第 2 维 | 4 | 框的 4 个距离:左 l、上 t、右 r、下 b。 注意不是绝对坐标,是相对该候选点的偏移量 |
| 1 | 类别分数。本课题只有 Pollo 一类,所以是 1 位 | |
| 第 3 维 | 8400 | 8400 个候选点,每个点都有上面 5 个数 |
nc + 5 位 —— 多出来的那一个是单独的
objectness(这里有没有物体)。
YOLO26 的 no = nc + 4,去掉了 objectness,
直接让类别分数兼职干这件事。
实际影响:置信度不区分「框得准不准」和「是不是这一类」, 所以做阈值筛选时,调一个
conf 同时影响两件事 ——
这也是你 1 轮结果里最优阈值高到 0.943 的原因之一。
从「距离」还原成框:解码
模型输出的是 4 个距离,要用两步才能变成人看得懂的框。 第一步先生成锚点(anchor point),也就是每个格子的中心:
锚点生成    make_anchors(..., grid_cell_offset=0.5)
            格子 (i, j) 的中心 = (i + 0.5, j + 0.5),再乘 stride 还原成像素坐标
            偏移取 0.5 而不是 0,是为了让锚点落在格子正中间

解码        dist2bbox(距离, 锚点)
            左上角 x1 = px − l        左上角 y1 = py − t
            右下角 x2 = px + r        右下角 y2 = py + b
为什么不直接让网络回归 x1,y1,x2,y2?两个原因:
- 尺度无关:同一个卷积核要在 stride 8 和 stride 32 上都工作。 如果直接回归绝对坐标,大尺度和小尺度的数值范围差了 4 倍, 权重很难同时学好。改回归「距离」,三个尺度就在同一个量纲上
- 锚点本身就是先验:网络只需要学「往左扩多少、往右扩多少」这种修正量, 起点已经很接近正确答案,学起来容易得多
训练时的三项损失
损失函数就是「老师给的评分标准」。你的训练日志里每轮会打印三个损失, 它们各自管一件事,数值大小完全不能互相比较:
| 损失 | 管什么 | 怎么算 | 你的 1 轮值 |
|---|---|---|---|
box_loss |
框画得准不准 | CIoU:同时看重叠面积、中心点距离、长宽比是否一致。 比单纯算 IoU 更能逼模型把框的形状也学对 | 2.486 |
cls_loss |
类别分得对不对 | BCE(二元交叉熵)。每个类别独立算,所以是「多标签」式的 | 3.240 |
l1_loss |
四个距离的数值误差 | 预测距离与真实距离的 L1 距离。 先归一化到 0~1 再算(乘 stride 后除以图像宽高), 所以数值天生就很小 | 0.0046 |
l1_loss = 0.0046,box_loss = 2.486 ——
差了 500 多倍,这不代表框回归学得很好,纯粹是量纲不同:
l1 归一化到了 0~1,CIoU 损失是 (1 − IoU) 再乘权重。
正确看法是各看各的趋势:三项都应该随轮数下降。
8400 个点里挑谁负责哪只鸡
这是整个训练里最容易被忽略、但影响最大的一步。 假设图里有 220 只鸡,8400 个候选点不可能全都算作「答对」—— 总得先决定哪些点「应该」输出这只鸡的框,这一步叫标签分配。
本课题用的分配器叫 TaskAlignedAssigner,打分公式是:
对齐分数 = (类别预测分数)1.0 × (IoU)6.0
           ↑ 分类项 α=1.0        ↑ 定位项 β=6.0

然后:对每个真实目标,按对齐分数取 top-k 个候选点,让它们负责这个目标。
关键在 α 和 β 的差距:β = 6 远大于 α = 1, 意思是位置重合度比类别判断重要得多。 这也符合直觉 —— 一个框位置都对不上的候选点,类别再自信也没有价值。
分配完之后还有一个细节:
- 被选中的候选点,它的目标分数不是简单的 0/1,而是按对齐分数加权过的「软标签」
(代码里
target_scores * norm_align_metric)。 越对齐,监督信号越强 - 如果同一个候选点被多个真实目标同时选中,就判给重叠度最高的那一个, 避免一个点要同时负责两只鸡
为什么 YOLO26 有两个检测头
这是本课题模型最有意思的设计,也是「YOLO26 号称不需要 NMS」的技术根源。 你的模型里其实有两套并行的检测头:
| 分支 | 分配方式 | 作用 |
|---|---|---|
| one2many 一对多 |
每个目标分配 top-10 个候选点 | 监督信号密集,学得快、收敛稳。 传统 YOLO 用的就是这一套 |
| one2one 一对一 |
每个目标只留 top-7 里最优的那 1 个 | 逼模型学会「一个目标只报一次」。 训练好了就天然不重复,不需要 NMS |
训练时两个分支一起更新,但组合权重是动态变化的:
训练初期    one2many 权重 0.8 ┃ one2one 权重 0.2   ← 先靠一对多快速学出雏形
训练末期    one2many 权重 0.1 ┃ one2one 权重 0.9   ← 再转向一对一,学「少报乱报」
            按轮数线性衰减,不是固定比例
x.detach()),所以它只影响检测头自己,
不会干扰主干网络学到的东西。② 两套头是并列存在的卷积层,推理时可以只启用其中一套 —— 这就是模型里
end2end 这个开关的作用:
打开就走 one2one、免 NMS;关闭就走 one2many + NMS。
推理收尾:过滤与去重
验证和实际使用时,网络输出还要再过几步才会变成最终结果:
- 置信度过滤:低于
conf阈值的候选框直接丢掉。 验证时阈值放得极低(0.001),是为了画出完整的 PR 曲线,不是最终使用值 - 数量截断
max_det:一张图最多保留多少个框。 默认是 300,本课题改成了 600 —— 因为本数据集单图最多有 1,151 个目标(验证集 594 个),用默认值会把真框直接砍掉, 表现为召回率被无辜压低、指标失真 - NMS 去重(
end2end关闭时): 把互相高度重叠的框合掉,只留分数最高的。 判断「重叠到什么程度算重复」由iou阈值控制,默认 0.7 - 坐标换算:把框从 640×640 的输入尺度还原回原图尺寸
Dataset images contain up to 594 objects (val=594), but max_det=300.
训练本身不会因此报错,但验证指标会失真 —— 后 294 个目标根本轮不到它们出现,召回率被人为砍掉一截。 做对比实验时如果不查这一项,很容易得出「模型不行」的错误结论。
这套实现对你课题的含义
| 实现机制 | 落到本课题上的影响 |
|---|---|
| P3 负责小目标,stride 8 | 鸡只中位框仅 15 × 31 px,几乎只能落在 P3 上。 这也解释了为什么「小目标检测」的改进手段对本课题收益最大 —— P4/P5 那 2000 个候选点基本用不上 |
| 候选点密集,每图平均 220 个目标 | 正负样本极度不平衡。1 轮结果里误检 179,564、漏检仅 9,949, 正是模型还分不清「哪只鸡是哪只」的表现 —— 一堆框都堆在鸡群上,但位置都没对准 |
| 没有独立 objectness 通道 | 调 conf 时同时影响「是不是鸡」和「框得准不准」两件事,
最优阈值因此偏高。做阈值分析时不能照搬其他论文的经验值 |
| one2one 权重按轮数从 0.2 升到 0.9 | 只训 1 轮时这个调度几乎没走完, 「少报乱报」的能力还没学到 —— 所以 1 轮的高误检率是预期表现,不能作为方法好坏的依据 |
| 框回归已移除 DFL | 如果写论文时描述「本文采用的 DFL 损失」会写错。 本项目实际是 box(CIoU) + cls(BCE) + l1 三项, 引用改进方法时要先确认该改进是否针对 DFL |
06基准结果
下表由各模型训练目录下的 results.csv 自动汇总(取 200 轮训练过程中的最优值),
按 mAP@50 降序排列。各指标的具体含义见 名词解释。
| # | 模型 | 轮数 | Precision | Recall | mAP@50 | mAP@50-95 |
|---|---|---|---|---|---|---|
| 1 | yolov9-m | 201 | 0.9597 | 0.9509 | ▲0.9792 | 0.7274 |
| 2 | yolov9-e | 201 | 0.9585 | 0.9573 | 0.9787 | 0.7440 |
| 3 | yolov9-c | 201 | 0.9596 | 0.9554 | 0.9781 | 0.7395 |
| 4 | yolov8-m | 200 | ▲0.9647 | 0.9489 | 0.9771 | 0.7677 |
| 5 | yolov5-m | 201 | 0.9627 | 0.9513 | 0.9759 | 0.7262 |
| 6 | yolov8-l | 200 | 0.9598 | 0.9442 | 0.9755 | 0.7742 |
| 7 | yolov5-s | 201 | 0.9597 | ▲0.9582 | 0.9754 | 0.6930 |
| 8 | yolov5-n | 201 | 0.9452 | 0.9492 | 0.9751 | 0.6388 |
| 9 | yolov8-n | 200 | 0.9506 | 0.9416 | 0.9751 | 0.6891 |
| 10 | yolov8-x | 200 | 0.9628 | 0.9429 | 0.9743 | ▲0.7743 |
| 11 | yolov8-s | 200 | 0.9597 | 0.9483 | 0.9738 | 0.7382 |
| 12 | yolov5-x | 201 | 0.9559 | 0.9523 | 0.9735 | 0.7248 |
| 13 | yolov10-l | 201 | 0.9594 | 0.9404 | 0.9732 | 0.7044 |
| 14 | yolov5-l | 201 | 0.9592 | 0.9487 | 0.9727 | 0.7276 |
| 15 | yolov10-s | 201 | 0.9518 | 0.9402 | 0.9724 | 0.6806 |
| 16 | yolov9-s | 200 | 0.9407 | 0.9469 | 0.9721 | 0.6984 |
| 17 | yolov10-x | 201 | 0.9574 | 0.9366 | 0.9717 | 0.6991 |
| 18 | yolov10-b | 201 | 0.9562 | 0.9384 | 0.9713 | 0.6953 |
| 19 | rtdetr-x | 201 | 0.9329 | 0.9288 | 0.9693 | 0.6346 |
| 20 | yolov10-m | 201 | 0.9462 | 0.9254 | 0.9681 | 0.6834 |
| 21 | rtdetr-l | 201 | 0.9369 | 0.9335 | 0.9678 | 0.6308 |
| 22 | yolov9-t | 200 | 0.9224 | 0.9212 | 0.9668 | 0.6454 |
| 23 | rtdetr-resnet50 | 201 | 0.9442 | 0.9384 | 0.9654 | 0.6401 |
| 24 | rtdetr-resnet101 | 201 | 0.9241 | 0.9218 | 0.9594 | 0.6124 |
| 25 | yolov10-n | 201 | 0.9187 | 0.9254 | 0.9594 | 0.6451 |
yolov9-m
yolov8-x
yolov8-m
yolov5-s
结果观察
- 整体水平很高:25 个模型中有 18 个 mAP@50 超过 0.97,说明鸡头目标在形态与纹理上特征显著,检测任务本身难度集中在小目标与遮挡边界。
- 小模型性价比突出:YOLOv5-n、YOLOv8-n 这类最轻量规格的 mAP@50 已达 0.9751,与同系列最大规格基本持平(差距在 0.002 以内),边缘部署优先考虑小模型。
- mAP@50 与 mAP@50-95 排名并不一致:YOLOv9-m 的 mAP@50 最高,但高 IoU 阈值下 YOLOv8-x / v8-l 更优,说明后者的框定位精度更好。若下游任务依赖精确边界(如温度反演取像素区域),应参考 mAP@50-95 而非 mAP@50。
- RT-DETR 组略低:mAP@50 集中在 0.959–0.969,且训练曲线收敛更平缓,符合 DETR 系在中小数据集上需要更长训练的特点。
- YOLOv10 的取舍在部署链路:v10-n 的 mAP@50-95(0.6451)反而低于 v8-n(0.6891),即框定位精度并没有提升;v10 的价值在于去除了 NMS,端到端推理更简洁。
07指标与名词解释
上表那些数字到底在衡量什么、训练命令里的一堆参数各自管什么 —— 这一节把它说清楚。 只看结论的话,记住一句就够:mAP@50 看“有没有找到”,mAP@50-95 看“框得准不准”。
评测指标
- TP / FP / FN真阳性 / 假阳性 / 假阴性
- 以某个 IoU 阈值判定“命中”后:TP = 检测框对了(框住了真实目标), FP = 误检(没有目标的地方也报了一个框), FN = 漏检(有目标但没检到)。后面几个指标本质上都是这三种数量的不同组合。
- IoU交并比
- 预测框与真实框的交集面积 ÷ 并集面积,取值 0~1。它用来判定两个框“算不算同一个目标”, 也是 mAP@50 / mAP@50-95 里那个 50 的含义来源。
- Precision精确率
-
TP / (TP + FP)。含义:报出来的框里,有多少是真的。 误检多,精确率就低。本课题中最高为 0.9647(YOLOv8-m)。 - Recall召回率
-
TP / (TP + FN)。含义:该找到的目标里,找到了多少。 漏检多,召回率就低。与精确率往往此消彼长,靠置信度阈值权衡。本课题中最高为 0.9582(YOLOv5-s)。 - AP平均精度
-
把置信度阈值从高到低扫一遗,每步得一组精确率/召回率,画出 P–R 曲线,
曲线下的面积就是 AP(单个类别)。
results.csv里的P_curve.png、PR_curve.png就是它。 - mAP@50IoU=0.5 时的平均精度
- 在 IoU 阈值 0.5 下(框与目标的重量超过一半就算命中)统计各类 AP 再取平均。 条件宽松,主要反映目标有没有被大略找到。因为只要粗定位就对,高密度遮挡场景下这个值容易很高。
- mAP@50-95IoU=0.5~0.95 的平均
- IoU 阈值从 0.5 到 0.95、步长 0.05 取 10 个,每个各算一次 mAP 再平均。 要求框贴得够紧才得分,所以比 mAP@50 严格得多、数值也低得多, 是更能区分模型优劣的指标。
- conf置信度阈值
-
只保留得分高于该值的检测框。调高 → 误检减少、漏检增多;调低反之。
AP/mAP 的计算会遍历所有阈值,所以训练时设为
null不影响指标。 - NMS非极大值抑制
- 同一个目标往往被多个相近的框命中,NMS 按得分保留最高的、抑制重叠过大的其余框。 YOLO 系需要这一步;RT-DETR 靠端到端集合预测,不需要 NMS,这也是它部署链路更简洁的原因。
- max_det单图最大检出数
- 一张图最多保留多少个框。高密度场景下这个值设得太小会直接截断召回率,本课题均为 300。
- box_loss / cls_loss / dfl_loss训练回归损失
- 训练日志里的三个损失项:box 控框的位置回归,cls 控类别分类, dfl 是 YOLOv8 起引入的分布焦点损失(把边界回归得更精细)。三者持续下降才说明在学东西。
训练超参
- epochs训练轮数
- 整个训练集被完整过一遗算 1 轮。本课题固定 200 轮,保证各模型对比公平。
- batch批大小
-
一次前向/反向传播送入网络的图像数。显存不足时优先降它(每次减半),
比降
imgsz对精度的影响小。 注意批大小还受标注密度影响:每个目标框都要占显存, 所以「每图几百个框」的数据集能开的 batch 会远小于「每图几个框」的通用数据集。 - imgsz输入尺寸
- 训练时把图像短边缩放到该边长(长边等比缩放,再补边成正方形)。 调大能提升小目标效果,但显存和周时成平方增长。本课题统一用 640。
- optimizer / lr0 / lrf优化器与学习率
-
optimizer 本次用 SGD(随机梯度下降);lr0 是初始学习率,
lrf 是最终学习率系数,实际末段学习率 =
lr0 × lrf。 本课题为 0.01 与 0.01,即从 0.01 线性退火到 0.0001。 - momentum / weight_decay动量与权重衰减
- momentum(0.937)让梯度下降带惯性、抑平震荡; weight_decay(0.0005)是 L2 正则,惩罚过大权重、抑制过拟合。
- warmup_epochs学习率预热
-
前 3 轮把学习率从极低值线性升到
lr0。 随机初始化的模型刚开局输出很乱,直接上大学习率容易把权重带飞。 - patience早停耐心值
- 连续多少轮验证指标没提升就提前停训。本课题设 50; 实际各模型都跑满 200 轮,说明还没碰到早停。
- close_mosaic末期关闭拼接增强
- 最后 10 轮关掉 mosaic。mosaic 拼出来的图与真实图像分布不一致, 末期关掉能让模型在真实分布上收收尾,通常带来小幅提升。
- amp自动混合精度
- 用 FP16 算大部分运算、关键处保留 FP32。省显存、提速,对精度影响很小。
- pretrained预训练权重
- 从 COCO 等大集上训好的权重开始微调,而非从零初始化。小数据集上几乎是必需的。
- workers / device / seed工程参数
- workers 数据加载线程数(8);device 使用的 GPU 编号(单卡 0); seed 与 deterministic 固定随机种子并开启确定性算法,保证实验可复现。
数据增强
- mosaic四图拼接
- 随机取四张图拼成一张。一次前向就见到四个不同场景, 相当于变相增大 batch,并让模型习惯目标出现在画面任意位置。
- fliplr / flipud水平 / 垂直翻转
- 按概率随机翻转。水平翻转(0.5)对鸡只外观几乎无损,是性价比最高的增强; 垂直翻转(0.0)会产生现实中不存在的倒立姿态,因此本课题关闭。
- hsv_h / hsv_s / hsv_v色彩扰动
- 分别扰动色相、饱和度、明度。用于模拟不同鸡舍的光照色温差异 (0.015 / 0.7 / 0.4)。
- translate / scale / degrees / shear几何变换
- 平移(0.1)、缩放(0.5)、旋转(0)、剪切(0)。 缩放幅度调到 0.5 是为了覆盖鸡只体型从小到大的尺度差异。
- auto_augment / erasing自动增强与随机擦除
- randaugment 自动从增强空间中采样策略; erasing(0.4)随机遮掉一块区域,模拟鸡只互相遮挡。
- mixup / copy_paste图像混叠与目标粘贴
- 两者均设为 0。前者会把两张图按比例叠加,在高密度遮挡场景下会生成不真实样本; 后者主要用于实例分割。
检测架构与数据集术语
- one-stage / two-stage单阶段 / 两阶段
- 单阶段(YOLO 系)直接回归出框与类别,速度快; 两阶段(Faster R-CNN 系)先生成候选区域再分类,更准但慢。 养殖场景要求实时与边缘部署,所以本课题以单阶段为主。
- RT-DETR / DETR端到端 Transformer 检测
- 把检测看作集合预测问题,用 Transformer 一次输出固定数量的框, 通过匈牙利匹配与真值一一对应,因此不需要 NMS。
- label assignment标签分配
- 训练时决定哪个预测框负责哪个真实框。YOLOv8/v10 用的是 TAL(Task-Aligned Assigner,按分类与回归的联合质量动态分配), 这比早期静态的 anchor 匹配更灵活。
- anchor-based / anchor-free锦点机制
- 前者预设一堆不同尺寸比例的参考框;后者直接从特征点回归。 YOLOv8/v10 与 RT-DETR 均属 anchor-free,超参更少。
- RGB-TIR可见光 + 热红外
- 同一场景分别用可见光相机与热像仪采集。 鸡只生病时体温先变化、外观未必有变化,所以热红外对健康监测比 RGB 更敏感。
- YOLO 标注格式归一化中心点框
-
每行一个目标:
class cx cy w h,后四个都是除以图宽高后的 0~1 浮点数。 用中心点而非左上角,是为了缩放时坐标跟着变。 - single_cls单类别模式
- 把所有权重按同一类处理。本课题数据只有“鸡头/鸡”一类,所以此项虽为 false 也不影响结果。
08如何开始训练
这一节是 PyCharm + Anaconda 的傻瓜式教学:从新建项目到训练出模型, 每一步都给可直接复制的命令和预期看到的结果。只要每步输出对得上, 就不用管背后的原理。第一次跑通约 20 分钟。
- 显卡:NVIDIA 独显。16 GB 显存建议 batch 从 16 起试(高密度标注数据集很吃显存)
- 硬盘:数据约 6 GB;每个模型的训练产物约 300 MB,建议留 50 GB 以上
- Anaconda + PyCharm:已安装好(本教程就按这个组合写)
- 时间:200 轮约 2–6 小时(视显卡而定),中途可随时 Ctrl+C 停下
全流程速查
熟练之后,整件事就是「装两个包、跑四个脚本」:
# PyCharm 底部 Terminal(会自动带上 (环境名) 前缀)
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu128
pip install ultralytics

# 然后按顺序在 PyCharm 里运行
check_dataset.py     # 数据体检:图片数 / 标签数 / 类别分布
split.py             # 按 9:1 划分 train / val
data.yaml            # 手写:告诉框架数据在哪、有几类
train.py             # 正式训练 200 轮
PyCharm 完整步骤(Windows + Anaconda)
从零到训练出模型的完整流程,针对 Windows + Anaconda + PyCharm 写成。
每一步都给可复制的命令和预期结果,示例按 RTX 5070 Ti + J:\poultry 这套配置写,
你按自己的实际路径替换即可。
- 显卡:
nvidia-smi→ RTX 5070 Ti,显存 16303 MiB,驱动 CUDA 13.4 - Anaconda:装在
E:\Anaconda3,已有 base / pythonproject8 / pythonproject9 - 磁盘:J: 剩约 68 GB(数据约 6 GB,每个模型产物约 300 MB)
- 还缺一个解压工具:Windows 自带能力解不了 rar,见 P5
新建训练项目
目标:得到一个干净的、装着训练依赖的 conda 环境。
文件 → 新建项目,按下表填写(以 PyCharm 2026.2 中文界面为准):
| 界面项 | 选什么 |
|---|---|
| 位置(L) | J:\poultry(纯英文路径) |
| 解释器类型 | 点 自定义环境(切勿选“基础 conda”) |
| 类型 | Conda(默认是 Virtualenv,必须手动改) |
| 环境 | 选择现有 |
| 环境(下拉) | poultry(先用命令行建好,见下方) |
2.13.0+cpu)。
用它训练会完全跑在 CPU 上,慢几十倍;后面 pip install GPU 版还会跟它冲突。
- 项目路径保持英文。中文路径会在读图时埋坑(见 P10 的注意点)
- “创建 Git 仓库”勾不勾都行,勾上更好;后续记得把
runs/、raw/、dataset/写进.gitignore
两条路都能走,选一条:
- 走 Conda(用现成环境):先在“Anaconda Prompt”里建环境
# 普通 PowerShell 里 conda 可能不在 PATH 上,用“Anaconda Prompt”最稳
conda create -n poultry python=3.10 -y
回到新建项目窗口:解释器类型 自定义环境 → 类型 Conda → 环境 选择现有 → 下拉选 poultry - 走 Virtualenv(一样能用):「基础 Python」下拉选
3.10.11(下载并安装),位置保持J:\poultry\venv。 venv 与 conda 环境对训练来说完全等价,只是会额外下载一个 Python
设置 → 项目 → Python 解释器 → 添加解释器 → 添加本地解释器,
直接浏览到 C:\Users\zzx\.conda\envs\poultry\python.exe。
conda 环境本质上就是个目录,指向它的 python.exe 必然可用。
确认 Terminal 用的是项目环境
目标:后面所有命令都在这个环境里执行,不用手动 activate。
按 Alt+F12 打开底部 Terminal(终端),看提示符前缀:
- 前缀是
(poultry)就对了,可以往下走 - 显示
(base)或没有前缀 → 检查右下角解释器是否为poultry; 仍不对就去设置 → 工具 → 终端调整 - PyCharm 默认终端是 PowerShell,所以后面调用带空格的 exe 路径要用
&前缀
装 PyTorch(这一步最容易装错)
目标:装一个能在你的显卡上跑的 PyTorch。
先把显卡查清楚:
nvidia-smi
然后按显卡架构选一行执行:
# RTX 50 系 / Blackwell(驱动 CUDA ≥ 12.8)—— 50 系只能选这行
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu128

# RTX 20/30/40 系,驱动 CUDA ≥ 12.1
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
sm_120,CUDA 12.1 的 PyTorch wheel 里
没有编译这个等级的计算核心。装错了不会在安装时报错,
而是在训练真正开始时才抛 no kernel image is available for execution on the device,
很难看出是版本问题。显存再大、驱动再新都救不了。
装完立刻验证:
python -c "import torch;print(torch.__version__, torch.cuda.is_available(), torch.cuda.get_device_name(0))"
- 中间必须是
True。若是False,说明装成了 CPU 版:pip uninstall torch torchvision -y后重装,注意别漏--index-url - 版本号带
+cu128/+cu121才是 GPU 版;带+cpu就是装错了
装 Ultralytics 训练框架
目标:装好框架,并确认它能找到显卡。
pip install ultralytics
yolo checks
yolo checks会打印环境自检表(Python / torch / CUDA / 内存 / 磁盘),逐项打勾即可- 报
No module named 'ultralytics'→ 多半是 Terminal 不在poultry环境里
装解压工具并把数据解压到英文目录
目标:拿到图像与标注,且路径里不含中文。
Windows 自己没有 rar 解压能力(自带的 tar 也读不了 RAR5),先装 7-Zip:
winget install 7zip.7zip
装完新开一个 Terminal,解压到英文目录(-o 后面是输出目录,不留空格):
# PowerShell 里调用带空格的 exe 路径要加 &
& "C:\Program Files\7-Zip\7z.exe" x "J:\研究生种鸡\Broiler Chicken Detection\data.rar" -oJ:\poultry\raw -y
cv2.imread 读非 ASCII 路径会直接失败并返回空值,
而 Ultralytics 底层就是用它读图。后果是扫描时显示“图片数量远少于实际”甚至 0 张,
报错信息里完全看不出跟路径有关,非常难查。所以数据放在
J:\poultry\raw 这类纯英文目录下。
训练前先给数据集做个体检
目标:在花几小时训练之前,把标签问题一次性揪出来。
在项目根目录新建 check_dataset.py,内容如下(改 ROOT 指向你的数据):
# check_dataset.py —— 统计图片数、标签数、类别分布,并列出异常
import pathlib, collections

ROOT = pathlib.Path("raw")          # 或 dataset
IMG_EXT = {".jpg", ".jpeg", ".png", ".bmp"}

def find_splits(root):
    img, lab = root / "images", root / "labels"
    if (img / "train").is_dir():                       # 已划分 train/val
        return [(s, img / s, lab / s) for s in ("train", "val")]
    return [("all", img, lab)]                          # 还没划分

for name, img_dir, lab_dir in find_splits(ROOT):
    if not img_dir.is_dir():
        print(f"[{name}] 找不到目录 {img_dir}"); continue
    imgs = [p for p in img_dir.iterdir() if p.suffix.lower() in IMG_EXT]
    labs = {p.stem: p for p in lab_dir.glob("*.txt")} if lab_dir.is_dir() else {}

    types = collections.Counter()
    missing, empty, bad = [], [], []
    for im in imgs:
        lab = labs.get(im.stem)
        if lab is None:
            missing.append(im.name); continue
        lines = [l for l in lab.read_text().splitlines() if l.strip()]
        if not lines:
            empty.append(im.name); continue
        for l in lines:
            parts = l.split()
            if len(parts) != 5:
                bad.append(f"{lab.name}: 列数不对 -> {l}"); continue
            try:
                c = int(parts[0]); x, y, w, h = map(float, parts[1:])
                if not all(0 <= v <= 1 for v in (x, y, w, h)):
                    bad.append(f"{lab.name}: 坐标越界 -> {l}")
                else:
                    types[c] += 1
            except ValueError:
                bad.append(f"{lab.name}: 数字解析失败 -> {l}")

    print(f"[{name}] 图片 {len(imgs)}  有标注 {len(imgs)-len(missing)-len(empty)}  "
          f"背景图 {len(empty)}  缺标签 {len(missing)}  异常 {len(bad)}")
    print(f"        类别分布(编号: 框数) {dict(sorted(types.items()))}")
    for title, lst in (("缺标签", missing), ("异常", bad)):
        for x in lst[:5]:
            print(f"        {title}: {x}")
        if len(lst) > 5:
            print(f"        {title}: ... 还有 {len(lst)-5} 条")
运行它(右键 → Run),预期看到类似输出:
- 缺标签 = 0:每张图都有对应 txt,命名没问题
- 异常 = 0:所有标注行都是 5 列、坐标都在 0~1 之间
- 类别分布只有一个键(这里是 0,对应"鸡"一类),和
data.yaml里的names对得上 - 如果 缺标签 很多 → 文件名大小写或扩展名不一致;异常 很多 → 标注格式不对, 需要先转换
划分训练集与验证集
目标:按 9:1 分好 train / val,并摆成框架要求的目录结构。
新建 split.py(如果你的数据已经带 train/val 划分,跳过这步):
# split.py
import random, shutil, pathlib

SRC   = pathlib.Path("raw")        # 原始 images/ 与 labels/
DST   = pathlib.Path("dataset")    # 输出目录
RATIO = 0.9                        # 训练集比例

imgs = sorted((SRC / "images").glob("*.jpg"))
random.seed(0); random.shuffle(imgs)
cut = int(len(imgs) * RATIO)

for split, group in (("train", imgs[:cut]), ("val", imgs[cut:])):
    (DST / "images" / split).mkdir(parents=True, exist_ok=True)
    (DST / "labels" / split).mkdir(parents=True, exist_ok=True)
    for p in group:
        shutil.copy(p, DST / "images" / split / p.name)
        lab = SRC / "labels" / (p.stem + ".txt")
        if lab.exists():
            shutil.copy(lab, DST / "labels" / split / lab.name)

print(f"训练 {cut} 张, 验证 {len(imgs) - cut} 张")
运行后目录应该是这样:
J:\poultry\dataset\
├── data.yaml
├── images\
│   ├── train\        训练图像
│   └── val\          验证图像
└── labels\
    ├── train\        与训练图像同名的 .txt
    └── val\          与验证图像同名的 .txt
abc.jpg ↔ abc.txt),
不靠目录顺序。所以两边必须一起移动,绝不能只挪一边。
划分完可以再跑一次 P6 的体检脚本把 ROOT 改成 dataset,
确认 train 和 val 两边都正常。
写 data.yaml
目标:告诉框架数据在哪、有几类。
在 J:\poultry\dataset\ 下新建 data.yaml:
path: J:/poultry/dataset
train: images/train
val: images/val

names:
  0: chicken
- Windows 路径统一用正斜杠
/,反斜杠在 YAML 里是转义符 path用绝对路径最省事;train/val是相对它的子路径names的编号必须和标注文件第一列一致(P6 体检输出里显示的就是实际编号)
先跑冒烟测试(最关键的一步)
目标:用一分钟验证整条链路通不通,再花几小时正式训练。
把 train.py 里的 SMOKE 设成 True(默认就是),右键运行。
它只取 2% 数据、跑 1 轮、用小尺寸,一分钟内出结果。
盯住输出里这两行 —— 下面是 PIO 数据集的真实输出:
- images 数量对得上吗?冒烟测试取 2%,所以是 1035 的 2% ≈ 21 张; 远少于这个数说明有文件没被识别。val 不受 2% 影响,始终是全部 452 张
- corrupt 必须是 0。不是 0 说明有损坏的图或格式不对的标签
- backgrounds 不能等于 images。全都成了 background,说明标签一张都没读到
然后打开它生成的那张预览图,这是眼见为实的一步:
J:\poultry\runs\detect\smoke\train_batch0.jpg
- 图上应该能看到画好的一堆矩形框,框住每一只鸡。这就是送进网络的真实样本
- 一个框都没有 → 标签没读到,回 P6 用体检脚本查,重点看「缺标签」和「异常」两项
- 同目录下的
labels.jpg是标注分布图。它其实描述的是数据集本身而不是模型, 具体怎么读见 08 训练产物的用途解读
正式训练
目标:跑满 200 轮,得到可用的权重。
改 train.py 顶部的开关,然后右键运行。四个开关就是全部需要动的地方:
SMOKE   = False         # True = 冒烟测试; False = 正式训练
EPOCHS  = 200           # ★ 轮数
BATCH   = 16            # ★ 批大小(见下方说明, 不是越大越好)
WORKERS = 4             # ★ 数据加载进程数(每个都是独立进程, 很吃内存)
MODEL   = "yolo26n.pt"  # 换模型只改这一行
完整的训练脚本(开关会自动换算成框架参数):
from ultralytics import YOLO

if __name__ == "__main__":          # Windows 上必须有, 见下方说明
    short = EPOCHS < 50
    model = YOLO(MODEL)
    model.train(
        data="data.yaml",
        epochs=1 if SMOKE else EPOCHS,
        imgsz=320 if SMOKE else 640,
        batch=4 if SMOKE else BATCH,
        fraction=0.02 if SMOKE else 1.0,
        device=0,
        optimizer="SGD", lr0=0.01, lrf=0.01,
        momentum=0.937, weight_decay=0.0005,
        warmup_epochs=0.5 if short else 3.0,
        patience=50,
        close_mosaic=0 if short else 10,
        max_det=600,                 # ★ 见下方"最有杀伤力的一个默认值"
        amp=True, seed=0, deterministic=True,
        workers=WORKERS,
        name="smoke" if SMOKE else f"exp_{MODEL.replace('.pt','')}_{EPOCHS}ep",
    )
max_det=300,意思是每张图最多输出 300 个框。
而 PIO 数据集单张图最多有 1,151 个目标(验证集 594 个)—— 超过 300 的那部分无论模型多准都报不出来,
召回率被硬性截断,验证指标失真。框架自己会打印警告:
WARNING Dataset images contain up to 594 objects (val=594), but max_det=300.
This mismatch can cap recall and produce invalid validation metrics.
所以必须显式设一个足够大的值(这里用 600)。 通用数据集每图几个目标,根本碰不到这个上限,这类坑只有高密度数据集才会遇到。
workers>0 会启用多进程加载数据。Windows 用 spawn 方式启动子进程,
缺了这一行子进程会重新执行整个脚本,表现为训练反复重启、日志重复输出。
batch 该开多大:看标注密度,不看显存总量
| 配置 | 实测显存 | 结果 |
|---|---|---|
| batch=16 @ 640 | 11.5 GB | ✅ 正常跑完 |
| batch=64 @ 640 | 17.6 GB | ❌ 超出 16 GB 可用显存,中途崩溃 |
为什么不能照搬「16 GB 显存开 64」这种经验值:每个目标框都要在显存里占一份, PIO 平均每图 220 个框、最多 1,151 个,是通用数据集(每图几个框)的几十倍。 batch 64 溢出后不会直接报「显存不足」,而是崩在数据增强环节,报错长这样:
- 连 1.17 MB 都分配不出来 → 显存溢出把系统内存也拖爆了, 看起来却像 OpenCV 或 numpy 的环境问题,很容易查错方向
- 正确做法:先跑一个小 batch,用
nvidia-smi看实占,留 2 GB 余量再往上加。 调整顺序是batch减半 → 再减半 → 最后才降imgsz - 想换模型:
yolo26s/m/l.pt、yolov8n/s/m.pt、rtdetr-l.pt等; 记得同时改name=,避免覆盖上次的结果
训练完了做三件事
目标:拿到指标、看到效果、导出可部署格式。
训练结束后,训练目录里的权重可以直接用。下面三条用 CLI 写(yolo 命令在装
Ultralytics 时会自动装上,若提示找不到,就用 Python API 里的
model.val() / model.predict() / model.export()):
# 1) 在验证集上重新评测, 得到与页面成绩表同口径的指标
yolo detect val model=runs/detect/exp_yolo26n_200ep/weights/best.pt data=data.yaml

# 2) 用新图做预测(单张 / 目录 / 视频都行)
yolo detect predict model=runs/detect/exp_yolo26n_200ep/weights/best.pt source=test_images save=true

# 3) 导出为 TorchScript, 便于部署到边缘设备
yolo export model=runs/detect/exp_yolo26n_200ep/weights/best.pt format=torchscript
- 只在验证集上评测、没有预测新图时,用第 1 条命令;
val不会输出图片, 要看到框必须用predict或val加save_json等参数 - 控制检出数量用
conf,具体该设多少看 09 节的 F1 曲线,不要用默认值拍脑袋 - 预测结果默认输出到
runs/detect/predict/ - 训练中途想停就 Ctrl+C,不会损坏数据;续训用
weights/last.pt(不是 best.pt)
把成绩汇总到本页的对比表
目标:把一次训练变成可横向对比的数据。
这个脚本属于网站仓库,不属于训练项目。它在
I:\PythonProject9\server\tools\ 下,必须在那个目录里执行 ——
在 J:\poultry 下敲会报「找不到文件」。分三步:
# 1) 先把当前目录切到网站仓库
cd I:\PythonProject9\server

# 2) 先试运行 —— 默认只预览, 不改任何文件
python tools/build_poultry_metrics.py "J:/poultry/results"

# 3) 确认无误后再真正写入
python tools/build_poultry_metrics.py "J:/poultry/results" --write
bash tools/deploy.sh          # 写入后还要部署才会上线
那个目录该怎么摆
两种摆法脚本都认,推荐用第二种:
# A) 直接用训练框架的输出目录(每个模型一个子目录)
J:\poultry\runs\detect\
├── exp_yolo26n_1ep\results.csv
└── exp_yolo26n_2ep\results.csv

# B) 自己汇总到一个文件夹,全部平铺(推荐)
J:\poultry\results\
├── exp_yolo26n_1ep_maxdet300.csv
└── exp_yolo26n_1ep_maxdet600.csv
- 为什么推荐 B:训练目录里会混进框架自己跑官方示例留下的 run
(比如
runs/detect/train,它是在 coco8 示例数据集上训的), 汇总到一个文件夹就能自己决定放哪些、把这类无关结果排除掉 - 平铺时模型名取文件名(去掉 .csv),
所以文件名就是网站上表格里显示的名字 —— 起成
exp_yolo26n_1ep_maxdet600这种能看出配置的, 不要用1.csv、结果.csv - 复制而不是移动:原训练目录保持完整, 以后查 args.yaml、看曲线图、续训都还要用到
runs/detect/train 也会被当成一个模型混进来。
所以脚本默认只预览不写入,并在写入前打印「当前 N 行 → 替换为 M 行」。 行数差异大就是一个提醒信号。
换了数据集训练,就不要往这张表里塞 —— 应该为本页单独开一张表。 具体放哪里可以自行决定,或直接问帮你维护页面的人。
- 把数据目录排除出索引:右键
J:\poultry\raw或dataset→标记目录为 → 排除。否则 PyCharm 会后台索引所有图片, 风扇狂转、编辑卡顿。runs\也一样 - 关掉“在输出控制台中模拟终端”(运行配置里)。 训练进度条会疯狂刷新,模拟终端模式更卡
- 解释器别选错:右下角可以直接切,切完 Terminal 会跟着变
- 项目里加 .gitignore:把
runs/、raw/、dataset/排除, 免得几个 G 的数据被 Git 收进去 - 训练时想看实时曲线:另开 Terminal 跑
Get-Content runs\train\exp_yolov8n\results.csv -Wait -Tail 5
要在 Linux / 服务器上训练?
14 步命令行流程本页讲的是 PyCharm 的做法。如果你要在 Linux 服务器上跑、或者习惯直接用命令行, 步骤与原理完全一样,只是把图形操作换成命令 —— 完整的 14 步另开了一页。
查看命令行完整步骤 →报错速查表
新手阶段绝大多数报错都在下面这张表里,按报错关键词对号入座:
| 报错 / 现象 | 原因 | 怎么解决 |
|---|---|---|
| No labels found in ... 或 backgrounds 等于图片总数 |
标签没被读到:文件名不对应、格式不对,或 data.yaml 指错目录 | 回第 9 步逐条排查,重点看 labels/ 与 images/ 是否同名 |
| CUDA out of memory | 显存不够 | batch 每次减半,再考虑降 imgsz;关掉其他占显存的程序 |
| torch not compiled with CUDA enabled 或 cuda.is_available() 返回 False |
装成了 CPU 版 PyTorch | 卸掉重装,命令里别漏 --index-url .../cu121 |
| ModuleNotFoundError: No module named 'ultralytics' | 没在正确的 Python 环境里 | 先 conda activate poultry 再执行 |
| Dataset 'xxx' images not found | data.yaml 里的路径写错 |
用绝对路径,斜杠统一用 /,路径里不要有中文和空格 |
| loss 变成 nan | 学习率过高 | lr0 从 0.01 降到 0.001 重跑 |
| 训练几十轮 mAP 一直是 0 | 标签类别索引与 names 不匹配,或标签没读到 |
核对标注文件第一列是否为 0;回第 9 步检查 |
| no kernel image is available for execution on the device | 显卡是 RTX 50 系(Blackwell, sm_120),却装了 CUDA 12.1 的 PyTorch | 重装 --index-url .../cu128 的版本;驱动需 CUDA ≥ 12.8 |
| 图片数量比实际少了很多 | 部分文件扩展名不被识别(.JPG 大写、.jpeg、.png 混放) |
统一转成小写 .jpg 后再训练 |
| 图片数量远少于实际,或直接为 0 (路径却检查不出问题) |
Windows 下的中文路径:cv2.imread 读非 ASCII 路径会失败 |
把数据移到纯英文目录再训练(如 J:\poultry\raw) |
| PyCharm 里训练反复重启、日志重复输出 | Windows 多进程 spawn 导致子进程重跑主脚本 | 训练代码包在 if __name__ == "__main__": 里 |
| Permission denied / Read-only file system | 权限不足或磁盘只读(Linux 常见) | 确认对数据目录有读写权限;df -h 看磁盘是否已满 |
| 训练到一半磁盘写满 | 每个模型产物约 300 MB,跑多个模型会累积 | 删掉不用的 runs/ 目录,或把 project= 指到大盘位 |
| 指标和别人差很多 | 验证集划分不同、图片尺寸不同,或预训练权重不同 | 固定 seed 与 deterministic=true,用同一份 data.yaml 对比 |
09训练产物的用途解读
一次训练会生成 20 个文件(约 20 MB)。文件名都是英文缩写,第一次看到很容易一脸茫然。 这一节把它们按「你什么时候会用到」分成三类,逐个说明用途。 下面的数字都来自本课题在 PIO 数据集上的真实运行结果,可以直接对照。
先看清文件都放在哪
训练涉及的所有文件都在下面这几个位置,先建立整体印象:
J:\poultry\
├── raw\                       ← 训练数据(images\ + labels\,共 1487 张图)
├── data.yaml                  ← 数据配置:数据在哪、有几类
├── train.py                   ← 训练脚本(顶部四个开关:轮数/批大小/进程数/模型)
├── check_dataset.py           ← 数据体检脚本(每次换数据后跑一次)
│
├── runs\detect\<运行名>\       ← ★ 完整训练产物(20 个文件,约 20 MB)
│   ├── weights\best.pt        ★ 最终要用的权重
│   ├── weights\last.pt        ★ 续训用的权重
│   ├── results.csv            逐轮指标(下面 results\ 里那份的原件)
│   └── ...另外 17 个文件
│
├── results\                   ← ★ 汇总的 results.csv(几百字节)
│   └── <运行名>.csv
│
├── datasets\coco8\            ← 框架自带示例数据(8 张图,与本研究无关,可删)
└── weights\yolo26n.pt         ← 下载的预训练权重
runs\,不会写到 results\。
results\ 是训练结束后由脚本把 results.csv 复制过去的汇总目录 ——
框架并不知道它存在。
结果分两层存放,各有各的用途
| 位置 | 文件数 / 大小 | 装什么 | 什么时候用 |
|---|---|---|---|
runs\detect\<运行名>\ |
20 个 / 约 20 MB | 完整产物:权重、7 张结果图、预测可视化、参数存档、results.csv | 要预测新图、要交论文效果图、要续训 —— 都从这里拿 |
results\<运行名>.csv |
1 个 / 几百字节 | 只有指标数字,是 results.csv 的副本 | 汇总到本页成绩表时用 |
为什么要分两层、而不是把 CSV 也留在 runs 里?三个原因:
- 可以自己挑选:训练目录里会混进框架跑官方示例留下的 run
(比如在 coco8 上训的
train), 汇总到一个文件夹就能把这类无关结果排除掉,不让它污染对比表 - 可读性好:
results\里全是 CSV,一眼看全; 而runs\里每个目录混着 20 个文件,几十次训练后就难翻了 - 文件名可控:平铺时文件名就是网站上表格里显示的模型名,
所以可以起成
exp_yolo26n_200ep_b16这样能看出配置的名字
train.py 里的运行名重复,框架不会覆盖,而是自动加后缀:
exp_yolo26n_1ep → -2 → -3 → -4。
光看目录名看不出哪个是哪个配置,事后只能一个个翻 args.yaml。
所以脚本里的运行名带上了关键配置:
exp_{模型}_{轮数}ep_b{批大小},
例如 exp_yolo26n_200ep_b16。换了配置就是另一个名字,不会撞。
results.csv 里一行代表什么
这个文件每轮一行,所以跑 200 轮就是「表头 + 200 行」。 只训 1 轮时,整个文件就只有两行 —— 下面是某次真实运行的全部内容:
epoch  time    train/box_loss  train/cls_loss  metrics/precision(B)  metrics/recall(B)  metrics/mAP50(B)  metrics/mAP50-95(B)
1      37.39   2.486           3.240           0.5725                0.6916             0.6445            0.2906
逐列含义:
| 列 | 含义 | 怎么判断好坏 |
|---|---|---|
epoch | 第几轮 | 行数 = 实际跑完的轮数 |
time | 这一轮耗时(秒) | 估总时长用;突然变慢说明有别的程序抢资源 |
train/box_loss | 训练集上的框位置回归损失 | 三个损失整体持续下降才算正常。 抖动正常,趋势向下就行 |
train/cls_loss | 训练集上的类别分类损失 | |
train/l1_loss | 辅助回归损失 | |
metrics/precision(B) | 报出来的框里有多少是真的 | 这四个是验证集指标。 要抄进论文的就是这四个 |
metrics/recall(B) | 该找到的找到了多少 | |
metrics/mAP50(B) | IoU=0.5 下的平均精度,论文最常报 | |
metrics/mAP50-95(B) | IoU 取 10 档平均,更严格、更能区分模型优劣 | |
val/box_loss 等三个 | 验证集上的同类损失 | 若训练损失降而验证损失翘头,就是过拟合 |
lr/pg0~pg2 | 三个参数组当前的学习率 | 应随轮数逐步衰减 |
metrics/mAP50-95 那一列排序,
最大值对应的 epoch 就是最优轮数。best.pt 存的就是那一轮。② 想判断有没有过拟合:比较
train/box_loss 与 val/box_loss 的趋势 ——
前者一直降、后者在中途开始上升,就是过拟合的信号。
| 文件 | 是什么 / 干什么用 | 什么时候看 |
|---|---|---|
| weights/best.pt | 验证指标最好的那一轮存下来的权重 | 预测新图、导出部署格式,都用它 |
| weights/last.pt | 最后一轮的权重,含优化器状态 | 只想续训时用它,不要用 best.pt |
| results.csv | 逐轮的损失与指标,纯数字 | 论文里要抄的指标就来自这里 |
| val_batch0~2_pred.jpg | 验证集的预测结果,框上带置信度 | 判断「模型到底会不会认」最快的方法 |
| val_batch0~2_labels.jpg | 同一批图的真值标注,用来和上面那张对照 | 对比预测与真值,看漏在哪、误在哪 |
| BoxPR_curve.png | 精确率–召回率曲线,曲线下面积就是 AP | 论文里放的那张效果图 |
| BoxF1_curve.png | F1 随置信度阈值的变化 | 写推理代码时用它定 conf |
| BoxP_curve.png / BoxR_curve.png | 精确率、召回率分别随阈值的变化 | 讲「精度与召回的权衡」时用 |
| confusion_matrix.png | 混淆矩阵:正确 / 误检 / 漏检各多少 | 诊断模型差在哪一头 |
| confusion_matrix_normalized.png | 同上,但按行归一化成比例 | 类别数多时比绝对值更好读 |
| results.png | 损失与指标随轮数的曲线总览 | 看收敛情况。轮数太少时没意义 |
| labels.jpg | 数据集的统计图,不是模型结果 | 分析数据集本身,见下文 |
| train_batch0~2.jpg | 送进网络的、增强后的训练样本 | 确认数据增强没把图搞坏 |
| args.yaml | 本次训练的全部参数存档 | 复现实验、写论文方法部分 |
① 判断模型行不行
先看结果数字:results.csv
这是唯一需要抄进论文的文件。只训 1 轮的实测值:
| 列名 | 1 轮实测 | 含义 |
|---|---|---|
| train/box_loss | 2.486 | 框位置回归损失 |
| train/cls_loss | 3.240 | 类别分类损失 |
| metrics/precision(B) | 0.573 | 报出来的框里有多少是真的 |
| metrics/recall(B) | 0.692 | 该找到的找到了多少 |
| metrics/mAP50(B) | 0.658 | 论文最常报的那个 |
| metrics/mAP50-95(B) | 0.295 | 更严格,更能区分模型优劣 |
指标的完整定义见 06 指标与名词解释。
再看图:val_batch*_pred.jpg vs _labels.jpg
这两个文件是成对的:_labels 是真值,_pred 是模型预测。
并排打开就能一眼看出漏检和误检在哪。
判断「模型到底会不会认鸡」,看这个比看数字快得多。
yolo26n.pt 是 COCO 预训练权重,而 COCO 里本来就有「鸟」这一类,有基础。
这也说明用预训练权重能省掉大量训练时间。
论文里放的那张图:BoxPR_curve.png
横轴召回率、纵轴精确率。曲线下的面积就是 AP,图上图例会直接给出数值。 本课题 1 轮的实测:
曲线的形状也有信息量:本课题这条曲线在召回率 0.5 之前精确率一直保持接近 1, 之后才快速下滑 —— 说明「有把握的框基本是对的,多报的框不可信」。
② 诊断问题出在哪
误检多还是漏检多:confusion_matrix.png
读法只有一句话:行 = 预测,列 = 真值,对角线 = 正确。本课题 1 轮的实测:
| 真值 = 鸡 | 真值 = 背景 | |
|---|---|---|
| 预测 = 鸡 | 63,910 ✅ 正确检出 | 179,564 ❌ 误检(虚报) |
| 预测 = 背景 | 9,949 ❌ 漏检(没报出来) | — |
注意 63,910 + 9,949 = 73,859,正好等于验证集的标注总数 —— 这两个数可以直接用来算召回率。
results.csv 里的 P=0.573 差很多。不要拿它当精度读数。
它的正确用法是看误检与漏检的相对关系:本课题现在是误检(17.9 万)远多于漏检(0.99 万), 说明模型还很「多疑」,到处报框。这是训练不足的典型特征, 跑到 200 轮这两组数字会明显改善。
部署时该用哪个置信度阈值:BoxF1_curve.png
横轴是你设的 conf 阈值,纵轴是 F1。曲线的最高点就是最优阈值。
本课题 1 轮的实测:
这个数字很说明问题:最优阈值高达 0.943,意思是「只有置信度超过 0.94 的框才可信」。 训练充分的模型这个最优值一般在 0.2~0.4 之间。 它印证了混淆矩阵的结论 —— 低分框基本都是噪声。
conf=0.943 而不是框架默认的 0.25。
F1 曲线是用来看阈值的,PR 曲线是用来看整体性能的,两者用途不同,别混。
做 200 轮或换了模型之后,重新看一次这条曲线 —— 最优阈值会往下走, 说明模型的置信度校准变好了。
收敛情况:results.png
损失和指标随轮数的曲线,一张图看完训练过程。 只训 1 轮时每条曲线只有一个点,看不出任何趋势,跑到几十轮以后才有意义。 判断标准:三个损失整体下降、mAP 持续上升、验证损失没有在中途翘头(翘头就是过拟合)。
③ 辅助与过程文件(注意:不都是模型结果)
labels.jpg —— 最容易误解的一个
三个子图分别是:
| 子图 | 看什么 |
|---|---|
| 左上 · 类别分布 | 每个类别有多少个框(单类别时就是总数) |
| 左下 · 中心点分布 | 框的中心落在图像什么位置,是否铺满全图 |
| 右下 · 宽高分布 | 框有多大 —— 这张最有价值 |
本课题 PIO 数据集的实测:
- 类别
Pollo共 253,429 个框(训练集),单类别 - 框的中心点铺满整张图,分布均匀
- 框的宽度集中在 0.025、高度在 0.03~0.05(归一化值)
这个事实直接解释了三件事:① 为什么高密度重叠处容易漏检; ② 为什么
batch 和 imgsz 都那么吃资源;③ 后续该往哪个方向改进 ——
提高输入尺寸、加强多尺度特征融合、用专门针对小目标的检测策略。
写论文时,这就是「问题分析」一节最有力的证据:不是空口说「鸡头目标小、检测困难」, 而是给出框尺寸的实测分布。
train_batch0~2.jpg —— 检查数据增强
这是经过 Mosaic 拼接和颜色扰动之后、真正送进网络的样本。 用途是确认增强没把数据搞坏:框有没有跟着图像一起变换、颜色是否失真过度、 拼接处有没有出现不合理的裁切。 如果发现大量框错位,说明标签格式有问题,要回训练前排查。
args.yaml —— 实验的可复现凭证
本次训练用的全部参数(几十项)。三个用途: ① 复现实验(别人照着这份参数就能重跑); ② 写论文方法部分(超参直接从这里抄,不用回忆); ③ 续训(框架会读回这份参数)。 不要删,也不要用新实验覆盖旧实验的目录。
速查:我想干什么 → 看哪个文件
| 你的目的 | 看这个 |
|---|---|
| 判断模型能不能用 | val_batch0_pred.jpg(和 _labels.jpg 对照) |
| 论文里要抄的指标 | results.csv |
| 论文里要放的效果图 | BoxPR_curve.png |
| 找出模型差在哪(误检还是漏检) | confusion_matrix.png |
| 写推理代码时定置信度阈值 | BoxF1_curve.png |
| 分析数据集本身的问题 | labels.jpg |
| 确认数据增强是否合理 | train_batch0.jpg |
| 看训练是否收敛 | results.png(轮数要多) |
| 续训 | weights/last.pt |
| 预测新图 / 导出部署格式 | weights/best.pt |
| 复现或写方法部分 | args.yaml |
要用来写论文,至少跑到 100 轮以上,并且用同一批图对比不同轮数/不同模型的产物, 才能得出可信的结论。
10资料与文件
本课题相关的原始资料与产出文件索引。
论文
| 文献 | 出处 | DOI |
|---|---|---|
| A Dataset of Visible Light and Thermal Infrared Images for Health Monitoring of Caged Laying Hens in Large-Scale Farming | Sensors 2024, 24(19), 6385 | 10.3390/s24196385 |
| PIO, a Large-Scale Dataset for Broiler Chicken Detection under Real Poultry Farming Conditions | Scientific Data (2026) 13:801 | 10.1038/s41597-026-07114-5 |
本地文件位置
以下资料保存在课题工作盘 J:\研究生种鸡\ 下:
| 路径 | 内容 |
|---|---|
BClayinghens-main/ | 25 个模型的完整训练产物(每个型号一个目录) |
BClayinghens-main/images/ | 数据集示意图(本页配图来源) |
Data Annotation Guide.docx | 标注规范说明 |
Broiler Chicken Detection/ | PIO 数据集:data.rar、Test 2025.rar、Videos 2023.rar |
FilePrefixCode.xlsx | PIO 图像命名规则对照表 |
Readme.txt | PIO 数据集说明 |
*.pdf | 两篇数据集论文全文 |
python tools/build_poultry_metrics.py 即可刷新,
再执行 bash tools/deploy.sh 发布。